

一个4B国产模型,被海外开发者“玩”出了什么花样?
2026-11-03 18:52

在Hugging Face的模型趋势榜上,一个来自中国的名字最近一直排在前三:讯飞星火X2.6-4B。
截至11月2日,星火X2.5/X2.6相关的官方模型和社区衍生版本,仅在这一个平台上的累计下载量就已经突破400万次,在这个庞大下载量的背后,有一群正在“动手”的海外开发者。
端侧模型落地有三道关卡:能不能干活、能不能随处跑、能不能被集成。下载只是开始,真正把模型跑起来、测出来、装进产品里,这才是大模型落地的核心挑战。
在海外开发者社区,围绕这个40亿参数的国产模型,有各种截然不同的玩法:有人把它拉进本地智能体的“考场”逐项打分,有人把它塞进浏览器、让网页直接调用显卡,还有人干脆把它做成了一款Mac应用里的Agent“心脏”。
Hermes Agent:6GB显存,30关过了25关
第一种玩法,是把它拉进“考场”,认认真真测一遍到底能不能干活。做这件事的witcheer,是一位长期在Mac mini等个人硬件上跑本地智能体的海外开发者,此前公开过OpenClaw与Hermes Agent在同一台Mac mini上的对比记录,关注内存架构、会话检索与本地模型的响应速度,是Hermes Agent社区里活跃的实测型用户。这一次,他把星火X2.6-4B的量化版本接入了本地智能体框架Hermes Agent,进行了一轮离线任务实测。
Hermes Agent这个平台不是在云端调API的评测,而是一套跑在本地、自托管的智能体框架与评测环境。任务全程离线完成,模型需要自己规划步骤、调用工具、读写文件,再由一套“LLM当裁判”的机制按评分标准逐项打分。这种评测最贴近真实使用场景,考验模型能不能把一件多步骤的活儿从头做到尾。
witcheer一共设置了30项离线智能体任务,覆盖文件处理、代码修改、代码重构、错误恢复等多种场景。最终,X2.6-4B通过了其中的25项。而在64K上下文的配置下,整个过程的显存峰值只有约6GB。作者因此把它列为这轮评测中,适配8GB显存档位里得分最高的模型文件。
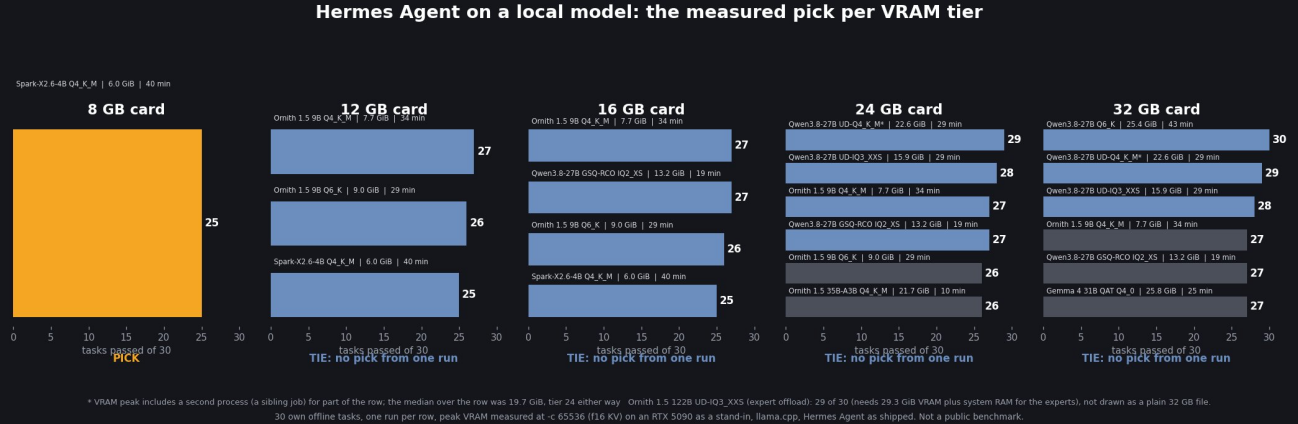
8GB显存,是当下大量消费级显卡(甚至是几年前的老卡)的主力配置。一个4B参数的模型,能在这样的“平民硬件”上,配合工具完成四分之三以上的复杂多步任务,说明端侧模型已经不只是“能回答问题”,而是真的可以“承接工作”了。这一点在硬件价格高涨的当下更显实用价值。
对个人开发者而言,这意味着文件批处理、代码辅助、本地信息整理这类活,有了放在自己电脑上低成本离线完成的可能,不必事事都往云端发。
类似的成绩并不止这一份评测。NanoBench社区公开的上报记录显示,X2.6-4B的Q8_0版本在Pi框架下取得97.5分,12项任务中11项完全通过,其中智能体任务和系统任务全部满分;BenchLM在10月29日更新的小模型索引中,X2.6-4B也位列百亿参数以下组综合估计评分首位。
浏览器里的AI:ONNX+WebGPU 给全球开源底层修了个bug
还有一种玩法更进一步,不仅让模型跑起来,更让它“随处都能跑”,把使用门槛压到最低。
做这件事的Mohd Mahmodi,是Hugging Face上专注浏览器端推理的社区开发者,主页持续更新Spark-X2.6系列的ONNX-WebGPU转换版本,也是这条链路上少数把模型、聊天Demo和源码一起公开的贡献者。这次,他把星火X2.6搬进了浏览器:在Hugging Face和GitHub上公开了Spark-X2.6-4B和1.7B两个版本的ONNX-WebGPU项目,让模型可以直接通过浏览器调用本机GPU运行,不用装Python,不用配环境,打开网页就能用。
这个平台的特点值得展开说说,他使用的是onnxruntime-web配合WebGPU:先把模型转换成ONNX格式,再借助浏览器新支持的WebGPU标准,让网页能够直接调度用户电脑上的显卡做推理。其验证报告显示,4B浏览器版本在数学和工具调用测试中分别取得90.5%和89.5%的成绩。开发者还在适配过程中推动修复了上游推理框架的通用问题。
这意味着,海外开发者不只是在消费星火X2.6,还在围绕它去反哺全球开源的底层工具链,一个国产端侧模型,成了推动通用推理框架变好的引子,国产大模型正在促进全球开发者生态繁荣。
Osaurus:从“被评测”到“被集成” 星火成了产品的“心脏”
如果说前两个案例还停留在开发者“个人折腾”的层面,那下面的案例,则代表了一个更成熟的信号:国产端侧模型开始被海外产品直接选作底座。
海外本地AI应用Osaurus,是一款macOS原生、以Swift写成、完全离线、以MIT协议开源的本地AI“承载框架”(harness),专为Apple Silicon优化。它的理念是:模型是可替换的、越来越便宜,真正不可替代的是模型之外的东西——使用者的上下文、记忆、工具和身份。别人把这些放在服务器上,Osaurus则把它们放在使用者自己的Mac上,并集成了带记忆的Agent、隔离沙箱、浏览器操作、MCP协议、加密身份等一整套能力。
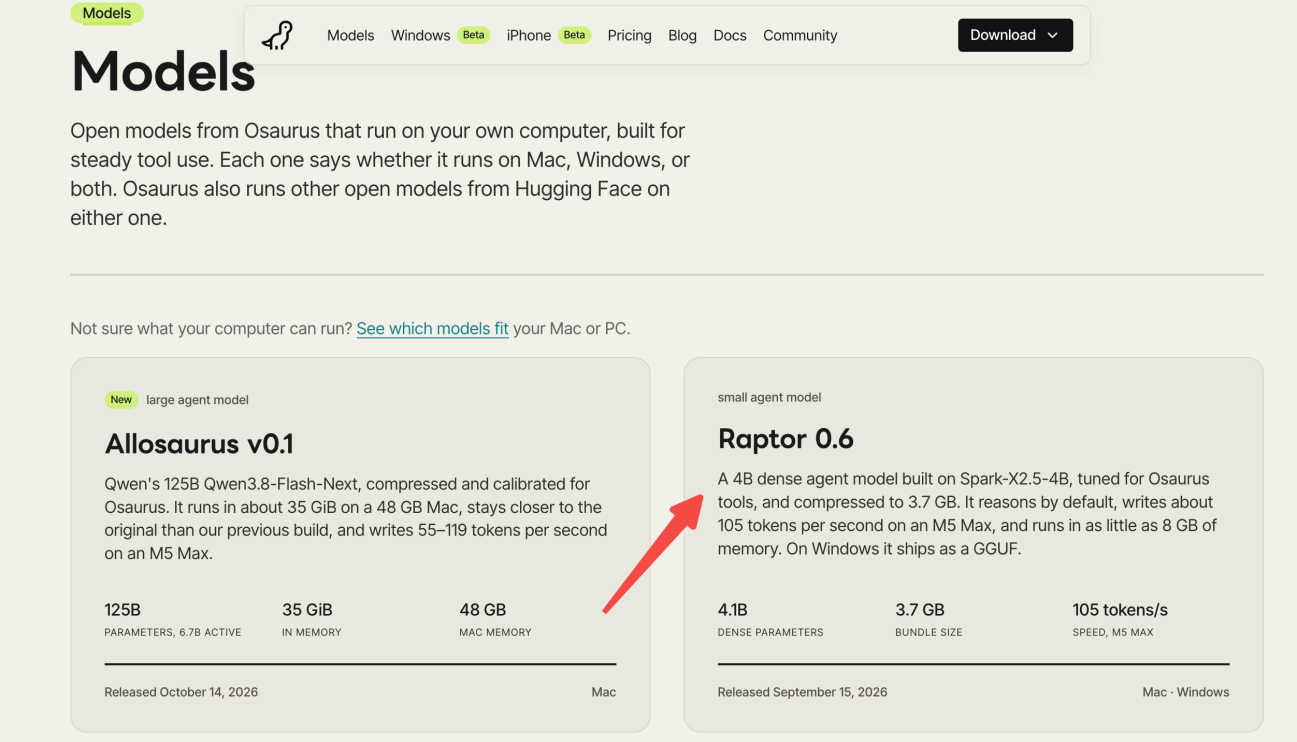
而Osaurus自带的本地智能体模型Raptor 0.6,采用的正是星火的上一代端侧模型X2.5-4B——早于本次发布的X2.6,就已经被海外产品选作底座。为什么选中星火?Osaurus给出的理由是:X2.5-4B是一个采用普通key/value注意力的稠密模型,没有需要担心被“污染”的循环状态(recurrent state),非常适合做需要稳定工具调用的Agent。这恰恰呼应了前面提到的、星火在架构层面对工具调用和长上下文的针对性设计。
从产品体验上看,这个集成做得相当彻底,Raptor 0.6被量化到约3.7GB,甚至在只有8GB内存的机器上也能常驻运行。装进产品之后,这个“星火心脏”要干的活包括:解析本地的文件夹和电子表格、把文档对照数据集逐条核验、撰写后续消息、执行工作流里的中间步骤……此刻,它不再是跑分的实验对象,它已经成为面向真实用户的成熟产品里默默干活的核心引擎。
为什么是星火X2.6-4B这个端侧模型?
这三个案例,恰好是端侧模型走向实用化的三个层次:Hermes Agent代表的是“能力验证”,在贴近真实的本地环境里,证明小模型确实能配合工具干多步的活;浏览器ONNX+WebGPU代表的是“部署普惠”,把使用门槛压到“打开网页即用”,让更多人用得上,顺带还反哺了开源底层;Osaurus代表的是“产品集成”,让模型成为成熟应用的默认底座,完成从技术到产品的质变。
这三条路径能同时跑通,靠的正是端侧模型的独特价值:隐私(数据不出本地)、离线(断网也能用)、低成本(一次下载,长期免费调用)。这也恰恰是科大讯飞“端云协同”战略想解决的问题——把该留在本地的留在本地,把该上云的交给云端。
而要把这些端侧优势真正兑现成“能干活”,还得看模型本身够不够硬。10月22日,在第十届科大讯飞全球1024开发者节上,科大讯飞董事长刘庆峰发布了端云一体的讯飞星火X2.6,并抛出了一个明确的判断:不是所有任务都值得丢给云端——涉及个人隐私、企业内部资料、科研数据的活儿,最好在本地就处理掉;只有真正需要强算力的复杂任务,再交给云端。X2.6-4B就是为端侧准备的主力:参数不大,却支持最高1M(百万)Token上下文和200多种语言,以Apache 2.0协议开源(意味着可商用、可自由微调),并原生适配Ollama、LM Studio等本地运行工具,以及llama.cpp、vLLM等主流推理框架,下载下来就能在各种环境里跑起来。
更关键的是它的“干活能力”。科大讯飞在1024开发者节上披露,通过端云一体训练(让云端教师模型指导端侧模型学习任务拆解、工具调用和连续执行),X2.6-4B把端侧智能体任务的独立完成率提升到了41.9%以上,而同尺寸端侧模型的平均水平大约只有12.8%;它还提供none/low/high三档可配置的“思考模式”,让开发者在响应速度、推理质量和资源消耗之间自己权衡。这些特性叠加在一起,正好踩中海外开发者的需求:一个足够小、能在消费级硬件上跑、又真能配合工具完成多步任务的开源模型。前面三个案例里跑出的成绩,也就不难理解了。
社区的活跃度,是这一切能规模化的关键。之前提到的400万次下载里,第三方衍生模型贡献了约58%;目前已能发现246个Hugging Face衍生模型仓库,以及51个有接入或源码证据的第三方GitHub项目。超过一半的下载来自社区衍生版本,这说明开发者不是在“看热闹”,而是真正在投入适配:压缩体积、转换格式、接入工具、做成产品。正是这些分散在全球的“二次开发”,把一个模型的能力,转化成了千行百业里能用得上的形态。
从这些海外案例中,我们看到一个越来越明显的趋势:国产端侧模型在海外的角色,正在从“被评测”走向“被深度使用”。这比排行榜的名次更重要,因为一个模型真正的生命力,不在发布会的PPT里,而在全球开发者愿意用它解决多少真实的问题。

相关热门新闻
请点击 添加到主屏幕